数据飞轮与 Scaling Law
因为公众号只允许作者 8 个字,ChatGPT 没有被感谢到(Google AI Pro 的 Argon 聊两句天就没了😡),感谢帮我搞引用
最近看到传闻,说 DeepSeek 即将训练一个 10T 参数的超级大模型。跟朋友聊天时,我的第一反应是,真的有那么大的数据量来喂饱这么大的 MoE 吗?事实上,从万亿参数基座面临的高质量语料瓶颈,到各类垂直领域的算法研发,数据稀缺性几乎是所有模型开发都难以回避的底层魔咒。
数据稀缺带来的一个直接后果,就是样本外风险更难控制。在有限样本上的高频试错,很容易逐渐演变为对历史噪声的死记硬背。一个极端的例子就是量化策略的过拟合问题。在实际投研中,由于高价值的市场数据极度有限且具备时效性,越临近实盘窗口的数据,就越应该限制其被反复回测和调参的次数。[1] 类似的问题也出现在 AutoResearch 上。如果要求 Agent 在同一个测试集上进行上百次调优,就很容易落入多重比较问题的陷阱,最终损害模型的泛化能力。[2] 面对这种存量数据自由度终将枯竭的死局,想到 OpenAI 和 Anthropic 已经开始通过合成数据与交互数据构建数据飞轮,甚至隐约摸到了左脚踩右脚上天的 RSI 门槛,这不免让人思考,在其他领域,我们是否也能走出一条类似的突围之路?
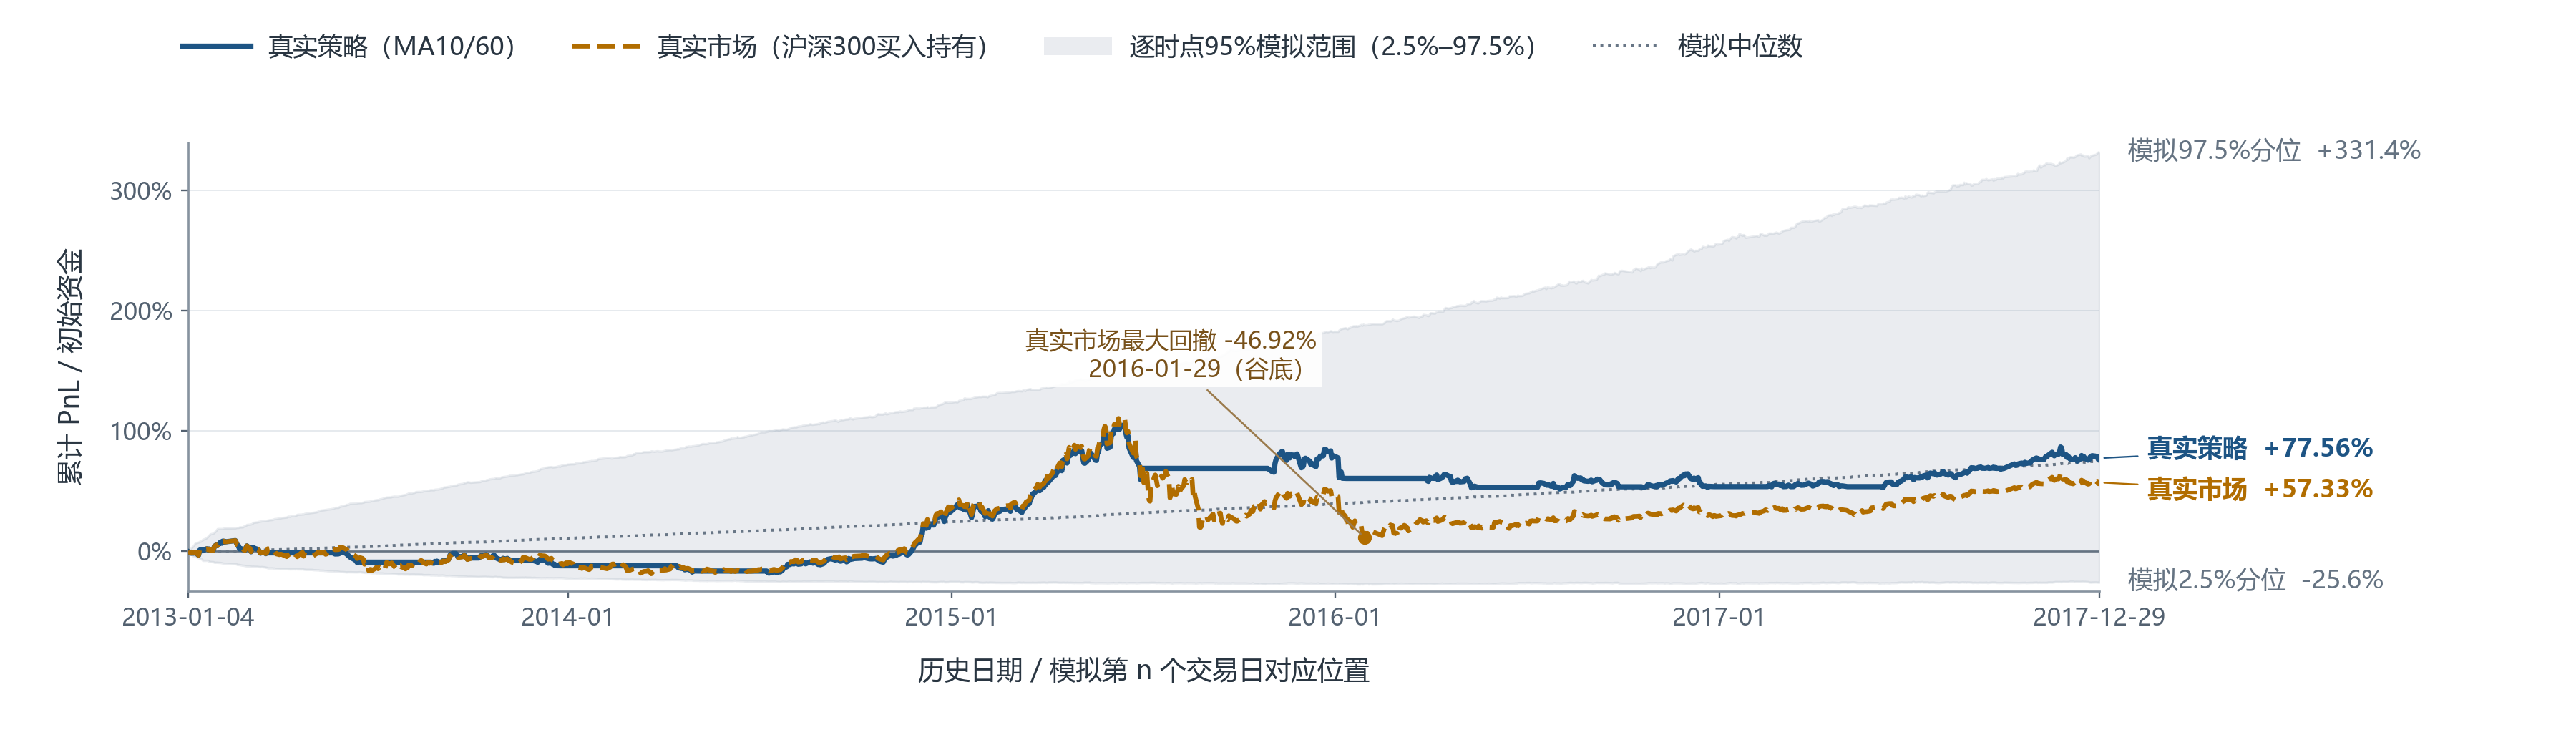
如果是基于技术分析的量化策略,其实我们还是有一定希望的。例如最简单的双均线策略,我们完全可以用 Monte Carlo 模拟生成成千上万条保留了真实波动率与动量特征的合成行情路径(下面是一个简单的例子)。在这些虚拟的平行宇宙中完成参数初筛与压力测试,就能减少对单一历史路径的反复拟合,把最珍贵的近期样本留给最终的单次盲测。其实这种路线很像大模型目前采用的 Rollout / Synthetic Trajectory Generation,试图通过有限的真实观测,生成大量可用于学习和评估的经验。[3,4]
以机械臂抓取杯子为例,Synthetic TG 可以从初始状态和给定动作序列出发,借助运动学或动力学模型生成完整的机械臂运动轨迹。而 Rollout 更强调递归决策的过程,机械臂每走一步,策略都会根据当前状态决定下一步动作,再由 Forward Dynamics 推进状态,直到完成任务。前者侧重依据给定条件构造轨迹,后者侧重通过连续决策与状态转移推演轨迹。
这里其实涉及到两种不同的数据飞轮。一种是 OpenAI、Anthropic 等头部实验室正在构建的,依赖高质量合成数据、真实交互反馈与客观验证机制持续迭代的闭环;另一种则是门槛更低、也更容易取得短期收益的低垂数据飞轮。后者往往只需要用户点赞、采纳率等浅层反馈,或者直接蒸馏模型自身输出,再不济用简单的随机过程进行 Monte Carlo 采样,就能迅速积累大量训练数据。这些方法在初期可能带来相当可观的 Benchmark 提升,让人误以为模型已经迈过了自我进化的 Milestone。但如果缺少可靠的环境建模和独立验证机制,这种闭环很容易陷入 Reward Hacking,甚至在反复的自我训练中走向 Distributional Collapse。[5]
真正可持续的数据飞轮,显然不能只是对存量信息的反复咀嚼,而必须建立在生成环境的保真度与外部验证机制之上。一个值得回顾的例子就是早期 LLM Community 的 Alpaca 浪潮。当时大量开源团队通过蒸馏 GPT-3.5 系列模型的输出,低成本批量构造指令微调数据,让一众小模型在指令遵循和部分评估上取得了立竿见影的进步,一时间似乎找到了绕开高质量语料瓶颈的捷径。[6] 然而,这种方式更多是在复制教师模型已有的知识与行为模式,而不是凭空创造新的信息。随后的研究也发现,模仿模型可能学到了强大教师模型的表达风格,却并未真正弥合事实知识和任务能力上的差距。[7] 而关于 Model Collapse 的研究则进一步揭示了另一重风险。当模型反复使用自身生成的数据进行训练,却缺乏外部真实分布的补充与校验时,原本就稀缺的长尾样本可能逐渐消失,生成分布也会随之收缩。[5] 模型看似越来越擅长输出格式精美、逻辑流畅的答案,实际上却可能在不断丧失对真实世界复杂性的刻画能力。虽然 Alpaca 式蒸馏并不必然导致 Model Collapse,但它所代表的低成本数据生产范式,恰好暴露了低垂飞轮的根本局限。如果模型始终只能从自己或教师已有的认知中寻找训练信号,又缺乏来自现实世界的独立纠错,那么无论生成多少数据,最终也不过是在越来越精致地重复已有的错误。
这也呼应了我之前对 DeepSeek Harness 的一个判断。我一直觉得,这类思路大概率会成为未来 RSI 系统的重要组成部分。如果 AI is smart enough,那么它自然也应该有能力解释自己的决策、诊断自己的能力短板,并主动寻找进一步压榨自身性能的方法。这有点像早年 GAN 的思路。当模型足够强时,我们或许可以让另一个与之对抗的模型专门负责生成具有挑战性的训练数据。例如,已经有人尝试使用 Agent Swarm 模拟未来的可能性,让不同视角、不同利益诉求的 Agent 在沙盒里互为对手盘。有的负责推演常规路径,有的专门负责找茬,制造黑天鹅和极端 Case。
这并不完全是科幻。国联民生证券金工团队在 2026 年 3 月就专门发布了一份 MiroFish 实测报告,将黄金走势、大类资产配置、产业政策及地缘冲突等问题放进多智能体沙盒中推演。[8] 海外也已经有研究团队将其应用于预测市场的实际测试。不过,这些实验也暴露了一个问题,群体推演能够拓展叙事和分析视角,却未必带来更准确的预测,而且很容易放大初始信息中的偏差。[8,9] 这本质上很像一种高维度的 GAN。既然真实世界给不出足够的数据,那就让足够聪明的模型分裂出无数个自己,在群体对抗中尽可能探索未来的各种可能性,自己给自己创造高信息密度的训练场。
回到我目前在做的 BCI 领域,大家都知道高质量数据十分稀缺,同时 Real World Application 中的数据也不可能真的足够干净。那么一个很自然的想法就是,我到底能不能把原本需要在真实受试者身上反复采集的脑电数据,搬到一个可以无限 Rollout 的虚拟大脑里?换句话说,能不能用有限的真实 EEG 训练一个足够可靠的 Neural World Model,让它按照给定的运动意图、认知任务、个体差异乃至病理状态,生成大量具有明确条件标签的合成神经信号?如果真能做到这一点,我们就不再需要为了提升一个四分类 Motor Imagery Decoder 的表现,让受试者戴着几十根电极,日复一日地重复那些枯燥的实验范式。而是可以让模型在数以百万计的虚拟 Trial 中完成预训练,最后只用少量真实数据进行校准。
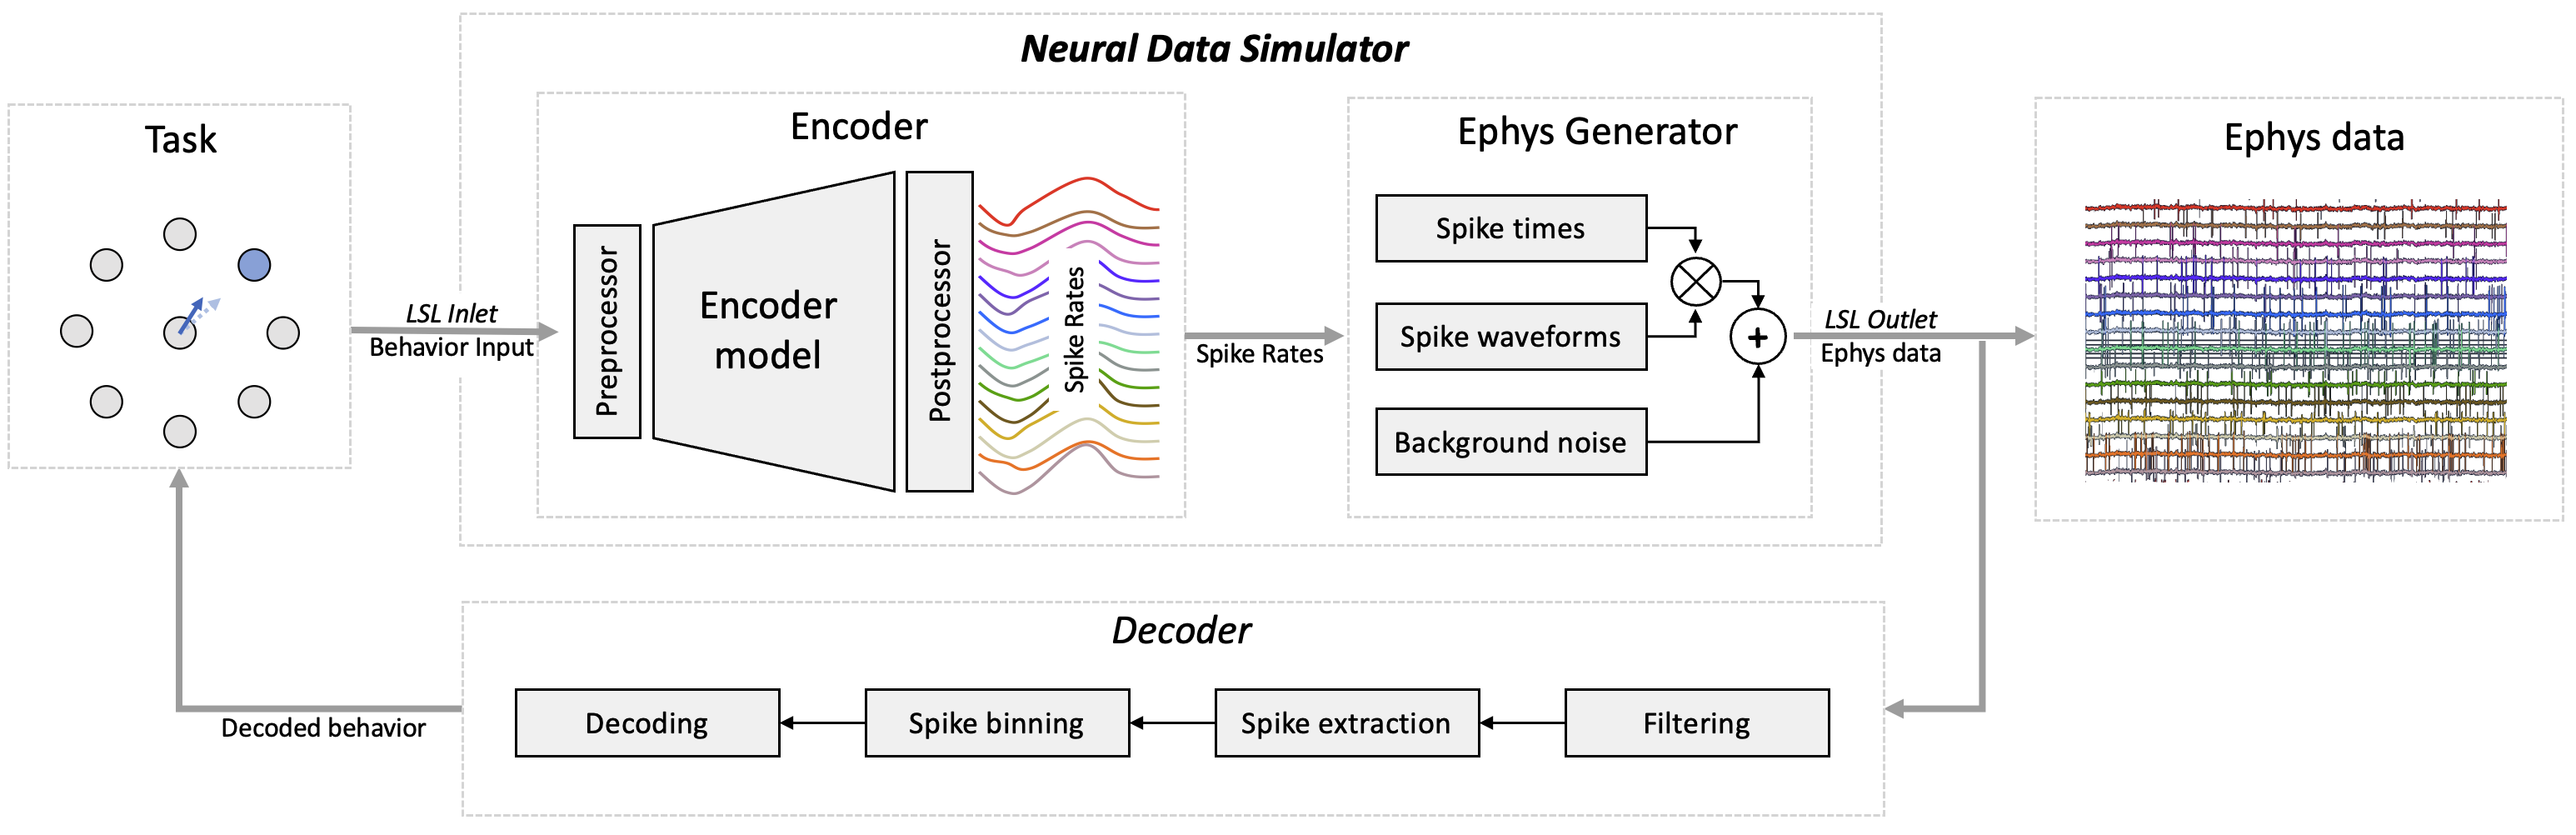
这种前沿探索在一些湾区初创公司中已经初现雏形。例如,Zyphra 近期推出的 ZUNA 1.1,虽然核心目标是脑电信号的超分辨率重建,但它同样提供了一种值得关注的表征学习思路。[10] 从真实采集的角度,更丰富的电极空间观测有时能够缓解稀疏采样带来的信息瓶颈,帮助模型捕捉更完整的空间特征,但具体收益仍然取决于任务和通道配置。[11] 而对于 Few-channel 设备,ZUNA 提供的是另一种可能性。利用预训练模型从有限观测中恢复更稠密的空间表征,或许可以改善不同 Montage 之间的兼容性,并为 Low-end 设备的下游适配铺平道路。当然,模型补全的虚拟通道并不等于新增了真实测量信息。AE Studio 则走了另一条路线,开源了 Neural Data Simulator,能够从光标或手臂运动等行为轨迹出发,生成对应的高维电生理活动,在无需真实受试者介入的情况下实现闭环 BCI 系统的仿真验证。[12] 无独有偶,Neuroelectrics 的 NeuroTwin 试图通过生物物理模型与神经网络动力学的耦合,构建患者的 Digital Brain Twin,从而在虚拟沙盒中模拟和推演不同电刺激条件下的神经动力学响应。[13]
其中最有意思的当属 Synchron。它在 2025 年宣布携手 NVIDIA 开发 Chiral 脑机基础模型,并计划引入 Cosmos 世界模型,试图在物理约束的虚拟环境中生成带标签的交互数据,以辅助运动解码。[14] 尽管其随后完成的 2 亿美元 D 轮融资不能完全归功于生成式 AI,但资本的押注至少表明,BCI 与基础模型结合的长期潜力正在得到越来越多的关注。[15] 尽管眼下尚无公司真正证明自己跑通了类似 LLM 后训练的可持续自我进化飞轮,但这些尝试已经指向一个值得关注的趋势。脑机接口的数据生产,正在从单纯依赖真实信号采集,逐渐延伸到基于神经动力学的条件生成与环境仿真。
只不过,相比文本,EEG 缺乏客观、廉价的 Verifiable Reward。生成模型固然可能拼凑出连医生都难辨真伪的脑电波,但最危险的不是信号太假,而是信号逼真,标签却全错。加之 EEG 本身混杂了体积传导、伪迹与严重的跨 Session 漂移,未经严格筛选的盲目增强不仅无益,反而可能把下游 Decoder 训练成一个更自信的垃圾分类器。
因此,我觉得 BCI 真正需要的,不是单纯无限扩参的 EEG 扩散模型,而是一个融合了神经源动力学与生物物理正向投影(Forward Model)的 Generative Neural World Model。它不仅能主动变换电极布局与伪迹条件来覆盖极限场景,更能像 Agent Swarm 一样,专门针对 Decoder 的 Failure Modes 制造对抗样本。然而,盲目对抗又很容易导致 Collaborative Reward Hacking。毕竟这样的模型无法仅凭想象,就证明自己想象出来的大脑与真实大脑一致。一个真正有效的飞轮,必须始终以从未参与生成的真实受试者、真实 Session,以及前瞻性的在线交互作为最终裁判。
BCI 真正的技术护城河,或许不只是私有的静态数据库,而是能否利用已有数据与神经科学知识,主动构造出那些罕见、却对泛化至关重要的反事实世界。当我们开始主动生成最具训练价值的神经场景时,数据稀缺所带来的泛化瓶颈,才有可能真正开始松动。
从信息论的角度看,合成数据当然不可能违背 Data Processing Inequality,凭空制造出原始观测中不存在的真实信息。但信息的总量与信息的利用效率并不是同一回事。Monte Carlo、Self-Play 和 Generative World Model 的价值,恰恰在于将有限观测与已有的结构性知识,转化为更多可计算、可检验的训练场景。真正的问题从来不是能否凭空创造信息,而是能否通过计算更充分地利用已有信息,再用稀缺的真实反馈不断修正世界模型的偏差。
回过头看,无论是量化中的 Monte Carlo、LLM 的 Rollout,还是 BCI 的 Neural World Model,本质上都是在试图用计算替代一部分昂贵的真实试错。但合成数据终究无法凭空创造关于现实世界的新信息,它只能帮助我们更高效地探索反事实的可能性。真正决定数据飞轮能否持续转动的,是现实世界能否不断推翻模型的错误假设,并将这些失败重新反馈给生成器。生成器负责扩张可能性的边界,真实反馈负责收缩我们对世界的不确定性。所谓突破数据稀缺的瓶颈,或许并不是让模型学会无限制造数据,而是让每一次稀缺的真实观测,都能排除尽可能多的错误世界。
参考文献
[1] Bailey, D. H., Borwein, J. M., López de Prado, M., & Zhu, Q. J. (2017). The Probability of Backtest Overfitting. Journal of Computational Finance. 论文链接
[2] Dwork, C., et al. (2015). The Reusable Holdout: Preserving Validity in Adaptive Data Analysis. Science. 论文链接
[3] Wang, Y., et al. (2024). RoboGen: Towards Unleashing Infinite Data for Automated Robot Learning via Generative Simulation. ICML 2024. 论文链接
[4] DeepSeek-AI, et al. (2025). DeepSeek-R1 Incentivizes Reasoning in LLMs through Reinforcement Learning. Nature. 论文链接
[5] Shumailov, I., et al. (2024). AI Models Collapse When Trained on Recursively Generated Data. Nature, 631, 755–759. 论文链接
[6] Taori, R., et al. (2023). Alpaca: A Strong, Replicable Instruction-Following Model. Stanford CRFM. 项目原文
[7] Gudibande, A., et al. (2024). The False Promise of Imitating Proprietary Language Models. ICLR 2024. 论文链接
[8] 国联民生证券金工团队,叶尔乐(2026)。Agent 专题报告:MiroFish 实测——多智能体宏观与行业趋势推演。2026 年 3 月 24 日。研报转载全文
[9] OrcaLayer Research. (2026). MiroFish on Polymarket: Can an AI Swarm of LLM Agents Forecast? October 5, 2026. 实验报告
[10] Warner, C., et al. (2026). ZUNA1.1: A More Flexible EEG Foundation Model for Denoising and Super-resolution. arXiv:2607.27308. 论文链接 · Zyphra 技术介绍
[11] EEG-based Motor Imagery Classification Accuracy Improves with Gradually Increased Channel Number. EMBC 2012. 论文链接
[12] AE Studio / Agency Enterprise. Neural Data Simulator (NDS). 官方文档 · GitHub
[13] Neuroelectrics. NeuroTwin: Personalized Digital Brain Models for Precision Neuromodulation. 官方技术介绍
[14] Synchron. (2025). Synchron Unveils Chiral™, the World’s First Cognitive AI Brain Foundation Model. March 19, 2025. 公司新闻稿
[15] Synchron. (2025). Synchron Raises $200 Million Series D to Advance Brain-Computer Interface Technology. November 6, 2025. 融资公告
本文于 2026 年 10 月 17 日首发于「科研甜品杂货铺」:微信公众号原文。